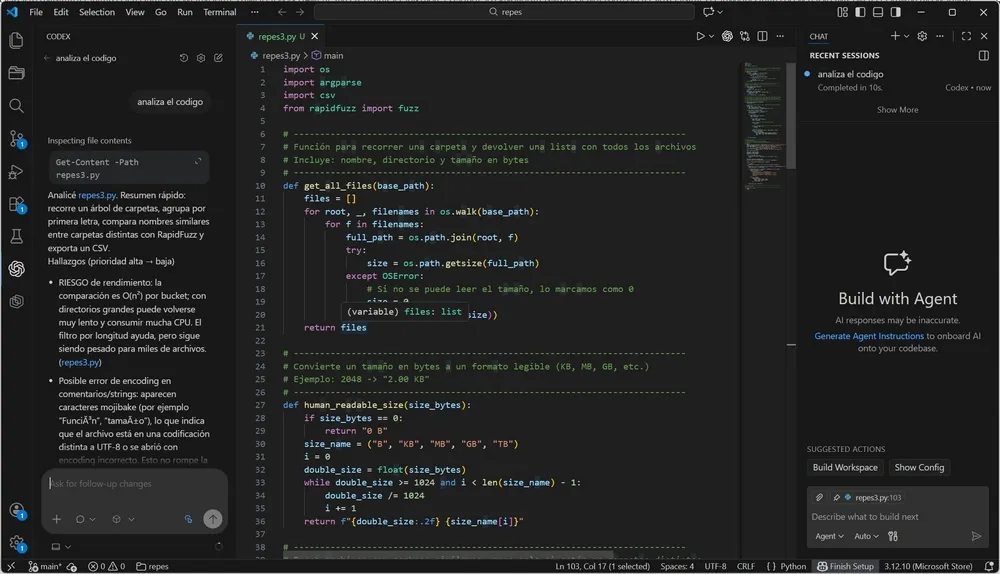
Visual Studio Code a ajouté un modèle de reconnaissance vocale qui fonctionne entièrement sur notre propre ordinateur. La nouveauté vous permet de dicter du texte et des commandes sans que cet audio ne soit jamais envoyé à des serveurs externes, un changement pertinent en termes de confidentialité pour ceux qui utilisent quotidiennement l'éditeur. Cette technologie, intégrée via Microsoft Foundry Local, élimine le besoin de recourir à des services tiers et est désormais disponible dans les versions stables de l'éditeur.
Jusqu'à présent, si l'on voulait dicter du texte dans l'éditeur, il fallait installer l'extension Discours VS Code ou recourir à des outils tiers qui, dans la plupart des cas, envoyaient notre audio à des serveurs distants pour le traiter. Cela a changé : l'environnement intègre en standard un système de dictée qui s'exécute directement sur la machine. La personne en charge de cette tâche est Nemotron 3.5 ASR Streaming 0,6Bun modèle développé par Nvidia qui fonctionne via Microsoft Foundry Local. En conservant tous les traitements sur l'appareil, la dépendance au cloud disparaît et nos conversations ou dictées de codes ne quittent pas l'environnement dans lequel nous travaillons.
Un modèle de 600 millions de paramètres dans VS Code
Nemotron 3.5 ASR Streaming 0.6B est un modèle open source avec 600 millions de paramètresconçu pour la transcription multilingue en temps réel et avec une faible latence. Il prend en charge plus de 40 langues grâce à un conditionnement rapide et inclut la détection automatique de la langue à partir d'un seul point de contrôle, sans qu'il soit nécessaire de charger différents points de contrôle selon les cas.
Son architecture, appelée FastConformer-RNNTtraite chaque nouveau fragment audio en réutilisant le contexte qu'il a déjà en cache, ce qui évite les calculs redondants et permet de fournir des transcriptions en moins de 100 millisecondes, avec des tailles de fragment configurables à partir de 80 millisecondes. Le modèle gère également la ponctuation et les majuscules de manière native, il n'est donc pas nécessaire d'appliquer un post-traitement pour obtenir un texte lisible. Sa petite taille lui permet de fonctionner facilement même sur des ordinateurs portables sans carte graphique dédiée, ce qui se remarque au quotidien car la dictée n'introduit pas de saccades ni de retards car elle ne dépend pas de la connexion réseau.
Dictée IA disponible dans l'éditeur et le terminal
La fonction ne reste pas dans une simple zone de texte : elle couvre une bonne partie des zones où l'on écrit au sein de l'éditeur. Nous pouvons l'utiliser dans Panneau de discussion et dans le Chat en ligne pour dicter des instructions à GitHub Copilot ou aux agents locaux, et fonctionne également dans l'éditeur de code, le terminal et les boîtes de validation Git.
Cette intégration remplace l'ancienne Extension vocale VS Codece qui était jusqu'à présent le seul moyen d'avoir des fonctions vocales dans l'éditeur. Dans de nombreux cas, la dictée apparaît active sans que nous ayons à toucher à quoi que ce soit, mais si nous ne la voyons pas, nous pouvons l'activer nous-mêmes : ouvrez simplement les paramètres avec Ctrl + , sous Windows et Linux, ou Cmd + , sous macOS, recherchez l'option dictation.enabled et vérifiez qu'elle est cochée. Une fois prêt, le raccourci le plus rapide pour commencer à dicter dans l'éditeur est Alt + Commande + V sur macOS ou Ctrl + Alt + V sur Windows et Linux, bien qu'il fonctionne également pour cliquer sur l'icône du microphone qui apparaît dans les zones de saisie telles que le chat Copilot.
Quelle est la fiabilité de la transcription lors de la dictée des invites
La qualité de la transcription est surprenante pour un modèle 0,6B fonctionnant entièrement localement, surtout si on l'utilise pour rédiger des notes, de la documentation ou du texte en Markdown. Cependant, là où son utilité est la plus visible, c'est lors de la dictée d'invites. modèles d'IA complexes au sein même de l'éditeur : au lieu de taper une longue instruction, prononcez-la simplement et laissez l'agent l'interpréter.
Lorsqu'il a été testé avec une invite technique commune, le modèle a correctement transcrit les phrases avec des remplissages et des corrections à la volée, y compris l'instruction de renommer une variable dans tout le code. La seule inadéquation est apparue avec les noms composés : lors de la dictée de « userData », la transcription l'a converti en « user data », séparant les deux termes. Ce n'est pas un échec grave, car l'agent IA qui reçoit ce texte comprend également qu'il fait référence à la variable qui doit être modifiée. Cette intégration de Nemotron 3.5 ASR Streaming 0.6B via Microsoft Foundry Local est désormais disponible pour ceux qui mettent à jour leur éditeur vers les dernières versions stables et consolide le traitement local comme chemin par défaut pour la dictée vocale dans VS Code.
FAQ sur la dictée vocale locale vs code Ouvrez les paramètres avec Ctrl + (ou Cmd +, sur macOS), recherchez l'option « dictation.enabled » et cochez la case. Vous pouvez ensuite dicter avec Alt + Commande + V sur macOS ou Ctrl + Alt + V sous Windows et Linux.
Le traitement s'effectue entièrement sur la machine via Microsoft Foundry Local, de sorte que l'audio ne quitte jamais la machine.
Il utilise Nemotron 3.5 ASR Streaming 0.6B, un modèle Nvidia à 600 millions de paramètres optimisé pour la transcription en temps réel avec une faible latence.
Comment activer la saisie vocale dans VS Code ?
La reconnaissance vocale VS Code envoie-t-elle des données vers le cloud ?
Quel modèle d'IA VS Code utilise-t-il pour la transcription ?